Programmer un robot avec IA : réutiliser et vérifier
Chercher, adapter, tester : les preuves derrière le code.
Programmer un robot avec l’IA : pourquoi réutiliser le code change la donne
Un agent de programmation reçoit une mission simple en apparence : trouver un chemin autour d’obstacles. Il peut écrire son propre algorithme ou rechercher un composant existant, puis l’adapter. Le résultat visible peut se ressembler ; le temps de développement, les erreurs et la facilité de vérification peuvent pourtant diverger. Cette différence devient importante lorsque le logiciel prépare les mouvements d’un robot.
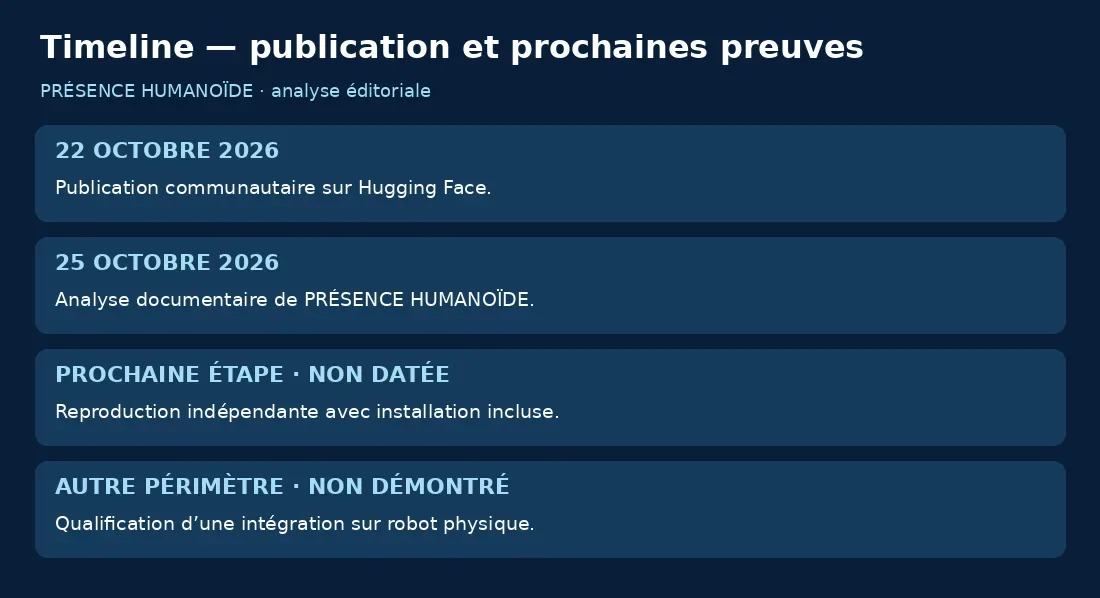
Une publication communautaire de BS Lee, datée du 22 octobre 2026 sur Hugging Face, compare ces approches avec Robot Skill Hub. Le petit benchmark compte trente essais sur trois tâches numériques ou simulées. Les auteurs rapportent un temps moyen de 31,9 secondes en développement direct contre 17,7 secondes avec réutilisation imposée, et respectivement treize et quinze exécutions satisfaisant tous les tests réservés sur quinze. Ce résultat est intéressant, mais ne mesure pas une exploitation physique. [BS Lee — benchmark communautaire, 22 octobre 2026]
Notre dossier part de cette expérience pour examiner une question durable : comment un agent peut-il assembler des briques vérifiables plutôt que réinventer chaque détail ? Les recommandations qui suivent sont des analyses de la rédaction, pas des performances supplémentaires attribuées au benchmark.
Notre méthode
Sources consultées le 25 octobre 2026. Petit benchmark communautaire, sans reproduction indépendante par la rédaction. Archives accessibles et titres récents examinés ; l’absence de doublon ne peut être garantie sur un inventaire incomplet.
Ce qui a été publié, et ce qui reste à reproduire
Le billet du 22 octobre décrit une comparaison avec le même modèle et les mêmes limites d’exécution. Les environnements étaient préparés en amont, avec un adaptateur expérimental pour les recettes. Le temps de recherche en ligne était compté, contrairement à l’installation initiale. Les tâches portaient sur un chemin sans obstacle, une trajectoire articulaire régulière et le positionnement d’un bras simulé. [BS Lee — benchmark communautaire, 22 octobre 2026]
La date de publication ne révèle pas la date exacte de chaque essai. Elle ne transforme pas non plus le résultat en validation indépendante. La page fournit des données et un lien vers un protocole figé ; ce dernier n’a pas pu être récupéré lors de notre consultation. Il faut donc conserver une différence entre la description des auteurs, les tableaux accessibles et une reproduction complète.
L’expérience constitue un signal sur une méthode de travail, pas un classement définitif des agents ou des bibliothèques. Une autre tâche, un environnement moins préparé ou une dépendance difficile à installer pourrait modifier le bilan. C’est précisément cette dépendance au contexte qui rend utile une analyse des conditions de réutilisation.
« let the agent start with working code »La proposition des auteurs : donner à l’agent un code fonctionnel comme point de départ. Source.
Une recette robotique n’est pas une compétence physique prête à livrer
Dans ce contexte, une recette désigne du code et une manière de l’appeler pour résoudre un problème défini. Elle peut calculer un chemin, produire une courbe ou estimer une configuration articulaire. Une compétence physique inclut davantage : capteurs, délais, actionneurs, limites mécaniques et réactions aux incidents. Confondre les deux conduit à surestimer la portée d’un outil logiciel.
Imaginons un programme qui retourne une liste de positions valides sur une carte. Ce programme ne sait pas nécessairement comment le robot freine, comment ses roues glissent ou si un obstacle est apparu depuis la dernière mesure. Pour en faire une fonction utilisable, il faut relier le calcul à une perception actualisée et à une commande capable de respecter les contraintes.
La réutilisation conserve toute sa valeur à condition de définir cette frontière. Une bonne bibliothèque réduit le travail sur un sous-problème ; elle ne prend pas automatiquement la responsabilité de l’ensemble. Le cahier des charges doit dire ce que reçoit la brique, ce qu’elle garantit et ce qui relève encore de l’intégration.
Pourquoi l’agent gagne parfois à chercher avant d’écrire
Un agent génératif peut produire rapidement une version plausible d’un algorithme connu. Mais plausible ne signifie pas correcte sur toutes les entrées. Il peut oublier une condition de bord, inverser un repère ou satisfaire uniquement l’exemple fourni. Une implémentation existante apporte un point de départ dont les choix et les limites peuvent déjà avoir été étudiés.
Chercher introduit néanmoins son propre coût. L’agent doit identifier le composant, vérifier sa compatibilité et comprendre son interface. Si la documentation est mauvaise ou la dépendance obsolète, l’économie disparaît. Le meilleur choix dépend donc du coût de compréhension comparé au coût d’implémentation et de qualification.
La bonne consigne n’est pas de réutiliser à tout prix. Elle consiste à examiner d’abord les solutions adaptées, puis à justifier un choix. Une fonction de quelques lignes, spécifique au projet, peut rester raisonnable à écrire. Un planificateur complexe, critique et déjà largement disponible appelle une démarche différente.
Trois niveaux de preuve à garder séparés
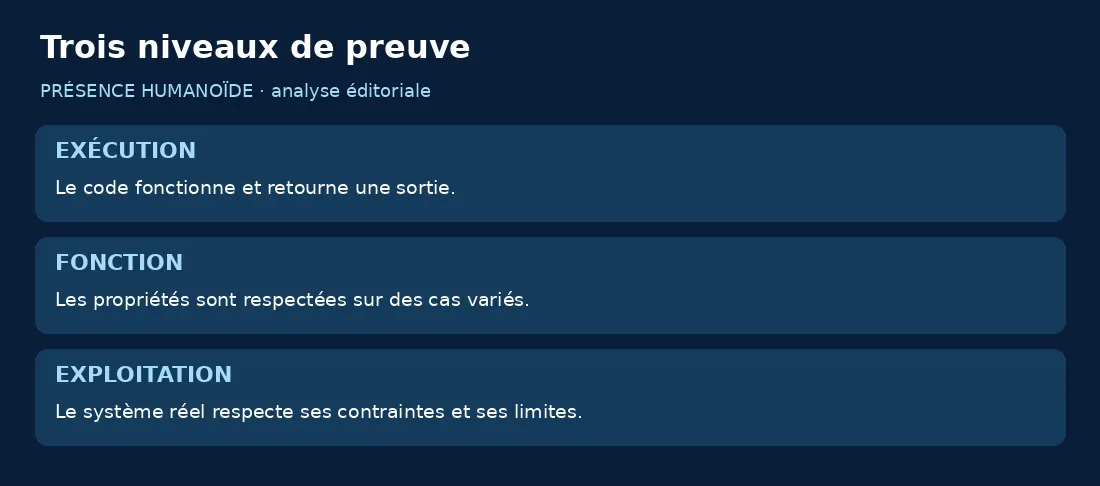
Le premier niveau est syntaxique : le programme s’exécute et produit une sortie de la forme attendue. Le deuxième est fonctionnel : il respecte des propriétés et réussit sur des entrées représentatives. Le troisième est opérationnel : il se comporte correctement dans le système réel, avec ses délais, ses pannes et ses contraintes. Une réussite au premier niveau ne permet pas de sauter les deux suivants.
Un exemple de trajectoire peut sembler fluide à l’écran tout en dépassant une limite de vitesse articulaire. Un résultat mathématique peut satisfaire une position finale sans respecter l’orientation de l’outil. Une commande correcte en simulation peut encore déclencher une protection sur le matériel. Chaque niveau demande des critères propres.
Le benchmark étudié reste dans le domaine numérique et simulé. Son intérêt concerne la génération et la vérification du code dans ce périmètre. Il ne justifie pas d’annoncer une amélioration de sécurité physique, de cadence industrielle ou de disponibilité. Ce cadrage permet d’utiliser l’expérience sans lui demander de prouver autre chose.
Planifier un chemin : l’exemple qui révèle les limites cachées
Un chemin doit relier un départ et une arrivée tout en respectant les obstacles. Sur une grille, plusieurs choix influencent le résultat : déplacement diagonal, coût des cellules, largeur du passage et traitement des limites. Un test trop simple laisse ces décisions invisibles. L’algorithme semble fonctionner jusqu’à l’apparition d’une carte un peu différente.
Pour un robot réel, l’objet déplacé possède une surface et pas seulement un point central. Une trajectoire qui passe entre deux obstacles sur la carte peut être impraticable pour son gabarit. Il faut aussi tenir compte des marges et de la qualité de localisation. Le calcul doit expliciter les hypothèses sur la représentation du robot.
Un protocole utile inclut une arrivée inaccessible, un départ invalide, un couloir étroit et des configurations aux frontières. Il vérifie la continuité et la validité de chaque étape, pas seulement l’existence d’une liste. Ce type de contrôle peut être indépendant de la solution choisie par l’agent et limite le risque d’un test adapté à son propre code.
Une trajectoire lisse doit aussi respecter le temps
Entre deux configurations articulaires, on peut interpoler des positions de nombreuses façons. Une courbe visuellement régulière ne garantit pas des vitesses, accélérations et variations d’accélération compatibles avec les moteurs. La dimension temporelle compte autant que la géométrie. Il faut préciser si la sortie décrit une forme de chemin ou une commande horodatée.
Prenons un exemple fictif : le même déplacement effectué en une seconde ou en cinq secondes conserve les mêmes points géométriques, mais impose des efforts différents. Un calculateur de trajectoire doit recevoir des limites et signaler lorsqu’une durée est irréalisable. Réduire le temps arbitrairement après calcul peut invalider les propriétés initiales.
La réutilisation peut aider si le composant documente les grandeurs qu’il contrôle. L’intégrateur doit toutefois vérifier les unités, l’ordre des articulations et les conventions de dérivation. Une erreur d’échelle ou de correspondance suffit à rendre dangereux un résultat parfaitement correct pour un autre robot.
La cinématique inverse ne résume pas une manipulation
La cinématique inverse cherche une configuration du robot correspondant à une cible. Plusieurs solutions peuvent exister, ou aucune. Certaines positions se trouvent proches d’une singularité ou d’une limite articulaire. Un solveur doit donc être évalué selon ses contraintes, ses tolérances et sa façon de signaler un échec.
Atteindre un point ne signifie pas tenir l’outil dans la bonne orientation. Cela ne garantit pas non plus que le trajet jusqu’à ce point évite les obstacles. Le bras peut toucher sa propre structure ou traverser une pièce pendant la transition. Un exemple de position finale ne couvre qu’une partie du problème.
Dans un projet sérieux, on teste les cibles inaccessibles, les configurations initiales variées et les limites. On sépare le solveur géométrique, la recherche d’un chemin et la commande. Cette séparation aide à localiser une erreur et permet de remplacer une brique sans réécrire toutes les autres.
Les tests réservés servent à sortir du scénario de démonstration
Un test réservé n’est pas communiqué à l’agent pendant la construction de sa solution. Il évalue donc la capacité à respecter une règle au-delà des exemples visibles. Son efficacité dépend de la diversité des cas et de leur lien avec le besoin. Un ensemble minuscule ou trop proche des exemples offre une protection limitée.
La comparaison publiée montre pourquoi cette distinction est utile, mais son faible effectif interdit d’en déduire une fiabilité universelle. Une absence d’échec sur quinze essais ne signifie pas un risque nul. Le rapport doit conserver le dénominateur et décrire exactement ce qui constitue une réussite.
Pour une équipe, la meilleure pratique consiste à garder une partie des scénarios hors de la boucle de développement, puis à renouveler les cas après plusieurs itérations. Si tous les exemples deviennent publics et familiers, ils peuvent finir par mesurer l’adaptation au test plutôt que la généralité de la fonction.
Temps, jetons et facture : trois mesures différentes
Les auteurs indiquent environ soixante-neuf pour cent de jetons de sortie en moins avec la réutilisation. Ils précisent que ce calcul concerne la sortie, pas la somme des entrées et sorties ni la facturation totale. Cette distinction évite un raccourci fréquent : une réduction d’un compteur ne prouve pas une économie financière équivalente. [BS Lee — benchmark communautaire, 22 octobre 2026]
Le temps mesuré dépend également de ce qui est inclus. Installer les paquets, télécharger des modèles ou construire un environnement peut dominer une première exécution. Une fois le poste préparé, ces coûts peuvent être amortis sur plusieurs tâches. Un bilan honnête présente le premier lancement et l’usage répété séparément.
Pour comparer deux méthodes, une entreprise devrait additionner recherche, intégration, calcul, vérification et maintenance. Une minute économisée par l’agent peut être négligeable si le composant ajoute une journée de diagnostic. Inversement, une dépendance bien choisie peut réduire durablement le nombre de corrections et simplifier les prochaines évolutions.
Timeline — une publication, pas un déploiement
Suite de l’analyse : choisir une brique que l’on peut maintenir
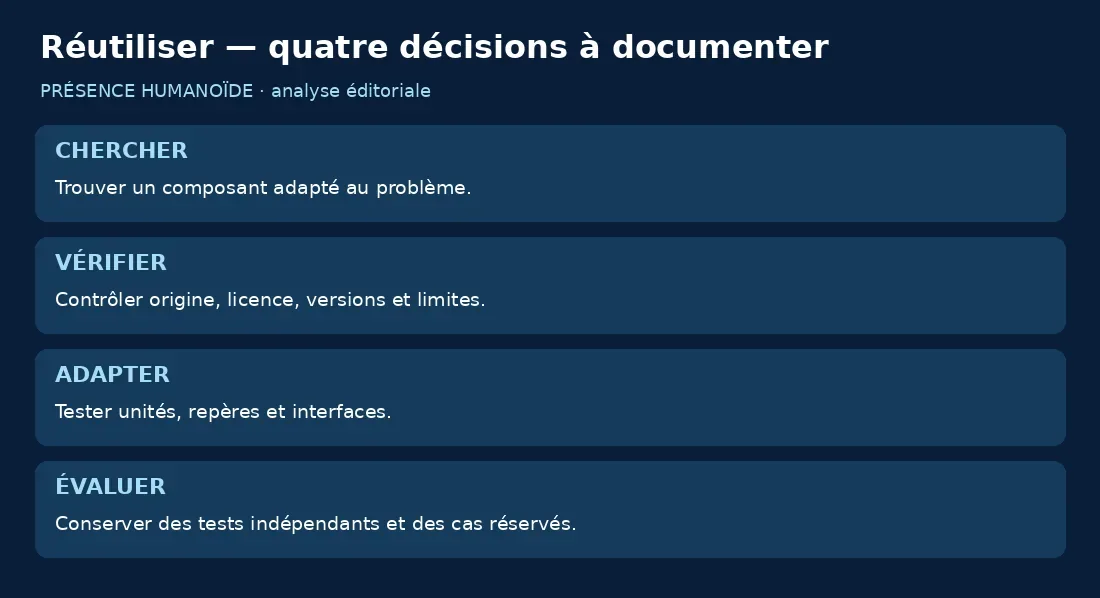
Le code disponible n’est pas nécessairement maintenu. Avant de l’intégrer, il faut examiner sa licence, ses versions, ses dépendances et les conditions de support. Un exemple académique peut être excellent pour apprendre tout en restant inadapté à une exploitation continue. L’agent doit savoir reconnaître cette différence au lieu de privilégier seulement la première réponse fonctionnelle.
La documentation devrait préciser les entrées, les sorties, les erreurs et les limites numériques. Un historique de corrections et des tests reproductibles apportent des indices utiles, sans constituer une garantie absolue. La stabilité d’une interface compte aussi : un changement mineur de paquet peut casser une chaîne d’automatisation mal figée.
Le bon inventaire relie chaque composant à son origine et à sa version exacte. Il indique pourquoi il a été choisi et comment le remplacer. Cette mémoire technique évite que le projet dépende d’une décision prise en quelques secondes par un agent, puis oubliée par l’équipe humaine.
ROS 2 et MoveIt : des exemples de séparation des responsabilités
L’écosystème robotique dispose déjà d’outils pour composer et tester des systèmes. La documentation ROS 2 décrit notamment launch_testing, qui permet d’observer les sorties et les codes de retour de processus pendant les tests. Ce genre d’outil aide à vérifier des interactions, au-delà d’une fonction isolée. [ROS 2 — documentation launch_testing]
MoveIt distingue la scène de planification, les contraintes et les vérifications de collision. Sa documentation expose notamment des contrôles de collision avec l’environnement et avec le robot lui-même. Cette architecture rappelle que produire une cible et vérifier son admissibilité sont des responsabilités distinctes. [MoveIt — scène et vérification de collision]
Ces références ne prouvent pas la qualité du benchmark ni celle de chaque recette. Elles montrent plutôt le niveau d’intégration qu’un projet doit organiser autour d’un calcul. Un agent peut contribuer à assembler ces éléments, à écrire des adaptateurs et à préparer les tests, à condition de conserver leurs frontières et de ne pas désactiver les contrôles pour obtenir un résultat.
Le rôle décisif de l’adaptateur
L’adaptateur traduit les données d’un projet dans l’interface d’une bibliothèque. Il paraît parfois secondaire, mais concentre des erreurs classiques : mètres contre millimètres, degrés contre radians, repères inversés et ordre des axes. Une bibliothèque correcte peut produire une mauvaise commande si cette traduction est fausse.
Il faut donc tester l’adaptateur avec des cas simples dont le résultat est compréhensible. Un mouvement sur un seul axe, une position neutre et une transformation inverse offrent des points de contrôle. Les tests devraient aussi rejeter les valeurs manquantes, les dimensions incohérentes et les nombres non finis.
Dans l’expérience étudiée, un adaptateur préparé facilite la réutilisation. Cette préparation fait partie des conditions du résultat. Pour une adoption réelle, il faut compter le travail nécessaire à sa création et à sa qualification. Le raccourci reste utile, mais il repose sur une infrastructure qu’une équipe a déjà construite.
Réutiliser introduit aussi des risques de dépendance
Une bibliothèque peut être abandonnée, compromise ou modifiée de façon incompatible. Un agent qui télécharge et exécute automatiquement du code élargit la surface d’attaque du projet. La provenance, les droits d’accès et l’isolation de l’exécution deviennent donc des critères de choix aussi importants que la rapidité du premier essai.
Un environnement de test devrait limiter les permissions et les accès réseau au nécessaire. Les versions peuvent être figées et les dépendances inventoriées. Les secrets de production ne doivent pas être présents dans un bac à sable où l’agent explore des composants inconnus. La séparation entre expérimentation et déploiement protège également contre une modification involontaire du système réel.
La licence mérite une lecture spécifique. Elle peut imposer des conditions de redistribution ou différer entre le code principal et ses dépendances. Une mention générale de logiciel ouvert ne suffit pas à établir les droits d’un produit commercial. L’équipe doit conserver la trace de cette vérification et des éventuelles obligations.
Simulation : nécessaire pour apprendre, insuffisante pour conclure
Une simulation permet de multiplier les essais sans exposer immédiatement le matériel. Elle reste dépendante de son modèle : géométrie, frottements, délais et capteurs. Un programme qui réussit dans cet univers peut rencontrer des écarts sur le robot physique. Ces écarts ne rendent pas la simulation inutile ; ils définissent son rôle dans une chaîne de validation.
Le passage au réel commence par une configuration conservatrice, des limites explicites et une surveillance adaptée. On compare les positions, les temps et les réactions attendues aux mesures. Une différence doit pouvoir être localisée : perception, transformation de repère, planification ou commande.
Le code généré ne devrait pas accéder directement aux actionneurs parce qu’il réussit un exemple numérique. Une procédure de mise en service reste nécessaire, avec une personne compétente et les protections de l’installation. La réutilisation d’un composant éprouvé aide à réduire l’incertitude sur une brique, sans supprimer celle du système complet.
Une méthode de travail en six décisions
La première décision définit le problème et ses critères. La deuxième recherche des composants adaptés. La troisième vérifie provenance, licence et compatibilité. La quatrième construit un adaptateur minimal avec des tests indépendants. La cinquième confronte le résultat aux cas réservés et aux échecs. La sixième décide si le composant est prêt à rejoindre une intégration plus large.
À chaque étape, l’agent doit produire une trace courte et utile : hypothèses, version retenue, limites et commandes de reproduction. Le but n’est pas d’accumuler des documents, mais de permettre à un autre ingénieur de reprendre le travail. Une solution rapide qui ne peut pas être reconstruite coûte souvent cher plus tard.
Cette méthode autorise aussi un refus raisonné de réutiliser. Si la dépendance est trop lourde ou son comportement mal documenté, une implémentation locale peut être préférable. La décision devient explicite et révisable, plutôt qu’un automatisme dicté par la disponibilité d’une recette.
Ce qu’une PME peut en tirer sans posséder de laboratoire
Une petite équipe peut commencer par ses outils numériques : préparation de trajectoires, vérification de fichiers ou tests d’interfaces. Elle n’a pas besoin d’acheter un humanoïde pour mesurer si un agent réduit les erreurs sur une tâche de logiciel. Le périmètre doit rester assez étroit pour que les résultats soient vérifiables avec ses moyens.
Un exemple serait un outil de contrôle d’une liste de positions avant import dans une cellule. L’agent peut aider à assembler un validateur et une série de cas invalides. Le résultat doit être revu par la personne responsable du processus ; il ne remplace pas les protections du robot.
Pour un atelier lié à l’architecture ou à la fabrication, les conventions d’unités et de repères sont déjà familières. Les mêmes disciplines s’appliquent au passage d’un modèle numérique vers un mouvement physique. La valeur commence par des données propres, une interface claire et une possibilité de revenir en arrière.
Les résultats qui feraient évoluer notre jugement
Une reproduction indépendante sur davantage de tâches renforcerait le signal initial. Elle devrait inclure l’installation, plusieurs environnements et différents niveaux de préparation. Il serait utile de comparer la réutilisation obligatoire à une stratégie où l’agent choisit librement de chercher ou d’écrire. Cela mesurerait sa capacité de décision, pas seulement la valeur d’une recette sélectionnée en amont.
Les rapports devraient publier la distribution des temps, les cas extrêmes et les échecs détaillés. Une moyenne peut masquer une méthode généralement rapide mais parfois bloquée. Les coûts complets, y compris les entrées et les appels d’outils, aideraient à comparer les usages répétés.
Enfin, un passage progressif à des systèmes physiques permettrait d’étudier la robustesse de l’intégration. Il faudrait alors mesurer les erreurs d’adaptateur, les interventions et les changements de configuration. Ce serait une nouvelle expérience, avec un périmètre différent, et non une conséquence automatiquement acquise des résultats logiciels.
Conclusion : l’agent utile sait aussi ne pas tout inventer
L’expérience Robot Skill Hub rappelle une idée simple : disposer d’un bon point de départ peut réduire le travail d’un agent. Son petit effectif et son environnement préparé obligent toutefois à garder des conclusions modestes. Le résultat ne démontre ni l’autonomie générale d’un robot ni une économie universelle sur les projets industriels.
La leçon la plus durable concerne l’organisation du développement. Rechercher, comprendre, adapter et vérifier sont des activités aussi importantes que générer du code. Une bibliothèque bien documentée peut stabiliser une brique ; des tests indépendants et une intégration traçable permettent de vérifier ce qu’elle apporte réellement.
Pour PRÉSENCE HUMANOÏDE, le prochain seuil de crédibilité sera la reproduction : mêmes tâches, conditions explicites, échecs visibles et coût complet. Lors de votre prochain projet, demandez à l’agent d’expliquer ce qu’il réutilise et comment il le teste. Cette question apporte souvent davantage qu’une démonstration qui fonctionne une seule fois.
FAQ — programmation robotique et agents IA
Robot Skill Hub est-il un robot ?
Non, c’est une collection de sources et de recettes logicielles pour des agents.
Le benchmark teste-t-il un robot physique ?
Non. Il porte sur des tâches numériques et de simulation.
Combien d’essais sont rapportés ?
Trente au total, répartis entre deux approches et trois tâches.
La réutilisation est-elle toujours préférable ?
Non. Le coût d’intégration et la compatibilité peuvent annuler le gain initial.
Le code réutilisé est-il automatiquement sûr ?
Non. Le composant, son adaptateur et l’intégration complète doivent être évalués.
Une réduction de jetons réduit-elle autant la facture ?
Pas nécessairement : il faut compter entrées, sorties, outils et autres coûts.
Pourquoi utiliser des tests réservés ?
Pour vérifier le comportement sur des entrées que l’agent n’a pas vues pendant le développement.
Les photographies montrent-elles l’expérience ?
Non. Ce sont des scènes conceptuelles générées par IA.
Sources et bibliographie
Consultées le 25 octobre 2026. Publication communautaire attribuée à son auteur, données associées et documentations officielles. Aucun essai physique de la rédaction.
- BS Lee — benchmark communautaire, 22 octobre 2026
- Robot Skill Hub — données expérimentales
- ROS 2 — documentation launch_testing
- MoveIt — scène et vérification de collision
Visuels créés avec la génération d’images intégrée : ingénierie logicielle, tests, obstacles, calibration et revue d’équipe. Photographie réaliste, palette bleu marine et blanc. Aucun résultat chiffré n’est illustré comme une mesure physique.
Suivez la robotique qui compte
Une analyse claire chaque jour.